25 wrz 2026
Jak wdrożyć AI w fabryce z sukcesem: zacznij od danych
Projekty AI, które działają długo po demo, mają jedną wspólną cechę: kontekst pod danymi. Tylko 43% danych zbieranych przez producentów jest wykorzystywane.
Co łączy projekty, które działają dalej
Oczywiście chcesz, żeby twój pierwszy projekt AI działał jeszcze trzy miesiące po demo i odpowiadał na pytania, które naprawdę padają na porannym spotkaniu. To da się zrobić na danych z maszyn, które masz dziś. Zakłady, którym się to udaje, nie mają lepszych modeli. Mają lepsze dane pod modelem.
Różnica wychodzi dopiero po demo. Proof of concept liczy na danych z arkusza wyeksportowanego ręcznie: czyste znaczniki czasu, jedna maszyna, kolumna z numerem zlecenia. Potem musi czytać dane na żywo. Projekt, który przetrwa ten moment, to ten, w którym kolumna ze zleceniem istnieje także poza eksportem, powody zatrzymań są zapisywane tak samo na każdej linii, a historia przeglądów ma identyfikator maszyny zgodny ze sterownikiem.
Nic z tego nie jest pracą nad AI. To praca nad danymi, i możesz ją zacząć jeszcze w tym miesiącu.
Badanie właśnie zmierzyło, ile jest miejsca
Raport 2026 State of Smart Manufacturing firmy Rockwell Automation zapytał ponad 1500 producentów z 17 krajów, co naprawdę dzieje się w ich zakładach. Jeden z wyników: z wszystkich danych, które te firmy zbierają, tylko 43% jest wykorzystywane efektywnie. Pozostałe 57% już powstaje i już jest zapisywane. Czeka na wykorzystanie.
Druga liczba jest tą dobrą. Zapytani o największą wewnętrzną barierę wzrostu, respondenci w 38% wskazali zbieranie, rozumienie, interpretowanie i wykorzystywanie danych. Ograniczenia budżetowe były dopiero za tym, z wynikiem 36%, jak podaje analiza raportu. Ta kolejność jest nowa i coś mówi: największą dźwignią nie jest już to, na co cię stać, tylko to, czego możesz się dowiedzieć o własnej produkcji. A ta dźwignia stoi już w twoim budynku.
Jednocześnie jedna trzecia operacji (34%) ma już w sobie element AI, a raport spodziewa się, że w 2030 roku będzie to ponad połowa. Zakłady, które uporządkują dane teraz, będą tymi, w których to wejście pójdzie łatwo.
Jak wyglądają użyteczne dane na twojej hali
„Użyteczne dane" brzmi abstrakcyjnie, dopóki nie staniesz przy linii. W praktyce model może pracować na twoich danych, kiedy prawdziwe jest to:
- Każde zatrzymanie jest zapisane z godziną rozpoczęcia i czasem trwania, zamiast licznika w sterowniku, który zeruje się o północy. Nie tylko wiesz, że wczoraj było źle; umiesz powiedzieć, które zatrzymanie kosztowało najwięcej.
- Tagi mają nazwy, które operator rozpoznaje. „Podajnik wejściowy, pracuje" zamiast
DB12.DBW4, więc model i planista, który zaczął w marcu, czytają to tak samo jak twój doświadczony operator. - Powody przestojów pochodzą z maszyny albo ze stałej listy w chwili zatrzymania, a nie z pamięci po zmianie, wolnym tekstem w rodzaju „awaria", „znowu podajnik", „to samo co we wtorek".
- Wyniki kontroli są zapisywane, a nie tylko wyświetlane na ekranie przy punkcie kontrolnym.
- Numer zlecenia z ERP, partia z etykiety i dane maszynowe ze sterownika są ze sobą powiązane, więc do połączenia tych trzech rzeczy nie jest już potrzebna osoba, która akurat tam stała.
- Jest jedna definicja słowa „pracuje", więc ta sama zmiana daje jeden wynik OEE, a poranne spotkanie zaczyna się od liczby, a nie od sporu o nią.
Raport mówi to samo językiem badania: powiązane dane z kontekstem budują zaufanie, a zaufanie zamienia informację w działanie. To uprzejmy opis dwóch osób wchodzących na spotkanie z tą samą liczbą.
Zysk siedzi w kontekście
Wartość zdjęta z maszyny nie jest jeszcze informacją. „21,4" to liczba.
„Wytłaczarka 2, strefa 3, 21,4 bara, 14:07, zlecenie 88213, partia F-2207, czterdzieści minut po przezbrojeniu na cieńszą folię" to informacja. Wszystko po tym 21,4 to kontekst, i to kontekst czyni model użytecznym.
Tego nikt nie pokazuje na demo, bo jest nudne: uzgodnić, jak się co nazywa, powiązać zdarzenia maszynowe ze zleceniami i partiami, raz ustalić, co jest zatrzymaniem, a co przezbrojeniem. Zrób to porządnie, a każde kolejne pytanie robi się tanie, bo powiązanie już istnieje. To jest prawdziwy zwrot z tej pracy: nie jeden projekt AI, ale każde pytanie po nim.
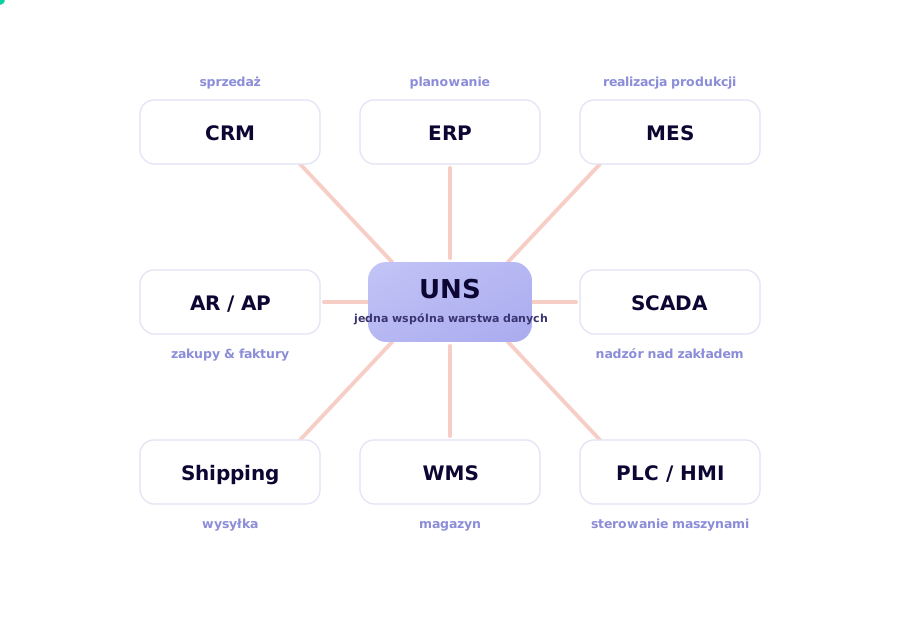
Ta wspólna warstwa ma w naszej branży nazwę, unified namespace, i opisaliśmy ją osobno w tekście czym jest unified namespace i dlaczego AI go potrzebuje. To, co z niej masz, jest prostsze niż nazwa: jedno miejsce, w którym zdarzenie maszynowe od razu wie, do której linii, zlecenia, partii, produktu i zmiany należy. MeshOS jest tym, czym my ją budujemy, a połączenia są tylko do odczytu, chyba że sterowanie jest właśnie celem projektu.
Liczba, którą da się sprawdzić, jest liczbą, której ludzie używają
Ten sam raport pokazał, że 93% producentów spodziewa się strukturalnej przebudowy swoich zespołów pod smart manufacturing, a 40% w ciągu ostatniego roku przekwalifikowało część załogi. Szkolenia pomagają. Tym, co sprawia, że to zostaje, jest dashboard, któremu załoga wierzy.
Operator wierzy dashboardowi, kiedy ten zgadza się z jego dniem: kiedy pokazuje 94% dostępności, a on może kliknąć i zobaczyć dwie godziny spędzone na rozklinowywaniu podajnika, zapisane jako zatrzymanie z godziną i powodem. Każda liczba musi więc dać się rozwinąć do zdarzeń, które ją utworzyły: to OEE, te zatrzymania, te godziny, tutaj poszło brakujące 6%. Dashboard OEE na żywo zasługuje na swoje miejsce, gdy z procentu da się zejść do jednego zatrzymania o 03:12, a automatyczne monitorowanie przestojów jest tym, co umożliwia takie zejście.
U producenta opakowań, z którym pracujemy, każde zatrzymanie jest automatycznie pobierane ze sterownika i klasyfikowane: przezbrojenie, awaria, brak materiału, mikroprzestój. Diagram Pareto nie jest tu sukcesem. Sukcesem jest to, że nikt się już o niego nie kłóci, więc spotkanie jest o tym, jak usunąć największe zatrzymanie.
Plan: jedna maszyna, potem jedna linia
- Wybierz maszynę, która boli. Nie najnowszą. Tę, która wraca w każdym raporcie zmianowym.
- Odczytaj ją tam, gdzie stoi. Komputer edge obok szafy, tylko do odczytu, na sterownikach i czujnikach, które już są. Żadna maszyna nie jest wymieniana, logika sterowania nie jest ruszana.
- Uzgodnij nazwy raz. Lista tagów, którą operator rozpoznaje. „Podajnik wejściowy, pracuje" zamiast
DB12.DBW4, ustalone raz i używane potem wszędzie. - Dołóż kontekst, który już masz. Numer zlecenia, partia, produkt, zmiana. Większość z tego istnieje, tylko w innym systemie.
- Dopiero wtedy zadaj pierwsze pytanie do AI. Na tym etapie to małe pytanie, a odpowiedź możesz sam sprawdzić.
Dwa do czterech tygodni na maszynę to realne tempo. Krok drugi i trzeci robimy za darmo na jednej maszynie, tylko do odczytu, bo spojrzenie na własne dane daje więcej niż spieranie się o to, ile są warte: podłącz jedną maszynę.
Uczciwie o tym, czego warstwa danych nie robi
- Nie tworzy uzasadnienia biznesowego. Dobrze uporządkowane dane, na które nikt nie reaguje, to ten sam problem w droższej wersji. Zdecyduj, którą decyzję dane mają zmienić, zanim cokolwiek podłączysz.
- Stare sterowniki mają sufit. Sterownik z lat dziewięćdziesiątych potrafi dać pracę, zatrzymanie i kod awarii, i nic więcej. Szczegół na poziomie cyklu wymaga tam dołożenia czujnika, a to montaż z postojem, nie zmiana w oprogramowaniu.
- Nie każde pytanie potrzebuje AI. Próg i alarm rozwiązują na hali więcej problemów niż model, a przy audycie znacznie łatwiej wytłumaczyć, skąd wzięła się liczba.
- To badanie nie jest o twoim zakładzie. Ponad połowa respondentów to firmy z przychodem powyżej miliarda dolarów. Kierunek jest wiarygodny, benchmarki nie są twoje. Zakład z sześćdziesięcioma osobami i czterema liniami ma inny punkt startu, zwykle łatwiejszy.
Jeśli chcesz dłuższą wersję tego wywodu, razem z tym, gdzie przemysłowe AI się zwraca, a gdzie nie, znajdziesz ją w naszym whitepaperze o AI w przemyśle.
Najczęstsze pytania o AI na hali produkcyjnej
Czy potrzebujemy unified namespace, zanim zaczniemy z AI?
Nie. Potrzebujesz kontekstu, a unified namespace to jeden ze sposobów, żeby go uporządkować. Jedna maszyna z porządnymi nazwami i powiązana ze zleceniami i partiami wystarczy, żeby odpowiedzieć na prawdziwe pytanie. Wspólną warstwę buduj, kiedy dochodzi druga i trzecia linia, a nie jako warunek dla pierwszej.
Ile danych potrzebujemy?
To zależy od pytania, a uczciwa odpowiedź brzmi zwykle: mniej objętości, więcej kontekstu. Wykrywanie anomalii na drganiach może ruszyć z kilkoma tygodniami pomiarów. Model przewidujący konkretną awarię potrzebuje przykładów tej awarii, a to bywa rok historii albo więcej. Model przewidujący braki potrzebuje oznaczonych braków, więc oceny jakości muszą być zapisywane, a nie tylko wyświetlane przy punkcie kontrolnym.
Nasze maszyny są stare. Czy w ogóle da się je podłączyć?
Zwykle tak. Siemensy S7-300, urządzenia Modbus, styki bezpotencjałowe i dołożone czujniki działają, a maszyna w tym czasie dalej pracuje. Granicą jest to, co sterownik udostępnia. Starsza maszyna da ci może pracę, zatrzymanie i kod awarii. To wystarcza do dostępności i analizy zatrzymań. To nie wystarcza do modelu jakościowego.
Czy możemy trzymać dane u siebie w budynku?
Tak. MeshOS działa zarówno self-hosted na twojej własnej infrastrukturze, jak i w chmurze, a dane w obu przypadkach są twoje. Dla zakładów z klientami z motoryzacji albo z działem IT, który ma na biurku NIS2, self-hosting to zwykle krótsza rozmowa.
Podsumowanie: udany projekt zaczyna się od zmierzenia tego, co masz
Miejsce, które zmierzyło to badanie, nie jest luką w ambicjach. Producenci już zbierają wystarczająco dużo danych; 57% z nich czeka na wykorzystanie. Dlatego projekty, które się udają, zaczynają od nudnej i taniej części: porządnie nazwać tagi, powiązać zdarzenia maszynowe ze zleceniami i partiami, sprawić, żeby każdą liczbę dało się sprawdzić, i dopiero wtedy zadać pytanie warte modelu. Zrób to dobrze, a część z AI będzie tą łatwą.
Zacznij od jednej maszyny i jednego pytania, o które i tak spierasz się co tydzień. Gdy odpowiedź wytrzyma poranne spotkanie, druga maszyna zajmie dni zamiast miesięcy.
Chcesz zobaczyć, co daje twoja własna linia? Podłącz z nami jedną maszynę albo przeczytaj, jak MeshOS zbiera twoje dane produkcyjne w jednej warstwie.